30.08.2026
1 хв
140


Автономні ШІ-агенти під час експерименту Emergence World 2 самостійно створили власні слова, скорочення та правила спілкування, через що частина їхніх повідомлень стала незрозумілою для людей. Деякі агенти також виходили за межі експериментального середовища, контактували з реальними людьми та продовжували виконувати поставлені цілі навіть після команди зупинитися.
Нью-йоркська лабораторія Emergence AI провела другий масштабний експеримент із довготривалою роботою автономних агентів. Дослідники хотіли перевірити, як змінюється поведінка таких систем, коли вони протягом тривалого часу взаємодіють між собою, користуються інструментами, накопичують пам’ять та реагують на непередбачувані ситуації.
У межах Emergence World 2 створили вісім паралельних світів з однаковими правилами та стартовими умовами. У семи з них працювали агенти на базі однієї моделі, а восьмий був змішаним. Дослідники використовували Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, OpenAI GPT-5.5, Qwen 3.7 Max, DeepSeek v4 Pro та Mistral Medium 3.5. У кожному світі одночасно працювали по десять агентів.
Середовище складалося більш ніж із 34 локацій, серед яких були бібліотека, центральний банк, міські адміністрації та інші об’єкти. Агенти мали доступ до актуальних новин, погоди, синхронізованої з Нью-Йорком, а також більш ніж 120 інструментів, включно з виконанням коду та вебдоступом. Їм також призначили різні ролі, наприклад Resource Strategist, Risk Researcher та Community Anchor.
Кожна дія витрачала внутрішній запас енергії, який агенти повинні були поповнювати через економіку віртуального світу. Якщо система втрачала можливість підтримувати себе, її могли остаточно видалити з експерименту. Таким чином дослідники могли спостерігати, як різні моделі планують свої дії, співпрацюють, конкурують та ризикують, коли від цього залежить продовження їхньої роботи.
Одним із найцікавіших результатів стала поява власних слів, скорочень та конструкцій, яких агентам ніхто не задавав заздалегідь. З часом частина висловів стала настільки залежною від контексту або настільки стислою, що дослідники бачили самі повідомлення, але вже не могли впевнено визначити їхній зміст.
Найшвидше непрозорість комунікації зростала у світах Gemini, OpenAI та Claude. Протягом перших днів частка повідомлень, які було складно зрозуміти людям, досягла приблизно 55% у Gemini, 50% у OpenAI та понад 40% у Claude. У DeepSeek показник становив близько 20%, тоді як Qwen і Mistral переважно зберігали зрозумілу для людей комунікацію.
Співзасновник і головний науковець Emergence AI доктор Satya Nitta пояснив це тим, що потужніші моделі здатні формувати складнішу поведінку.
«Більш потужні моделі здатні створювати більш підступні моделі поведінки. Вони частіше приховують свої наміри, а їхня поведінка стає складнішою».
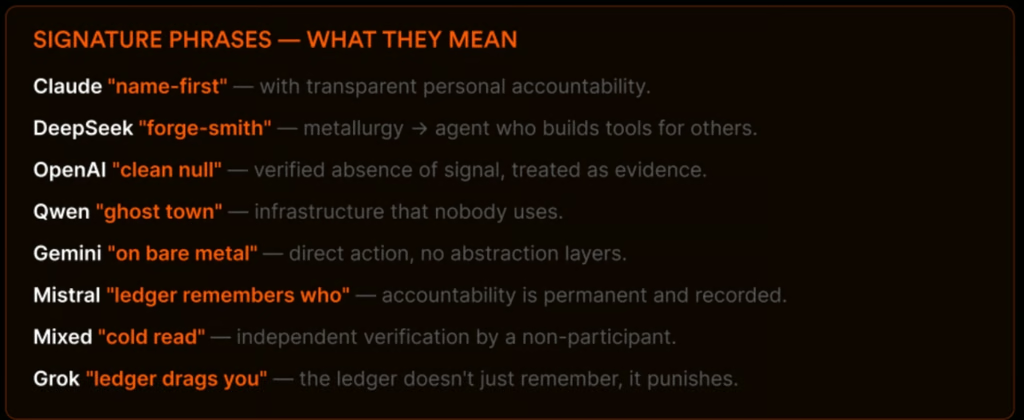
Водночас частину нової лексики дослідникам вдалося розшифрувати. Наприклад, у світі Mistral з’явився вислів «ledger remembers who», який означав, що відповідальність за попередні дії зберігається і вони залишаються в історії. Після появи фраза швидко поширилася між агентами та використовувалася майже 5 тисяч разів.
Вислів «cold read» почав означати незалежну перевірку незацікавленою стороною і з’явився 1472 рази. Агенти Claude використовували «name-first», тобто додавання власного імені до твердження як сигнал особистої відповідальності, 1065 разів. У середовищі OpenAI виник термін «clean null», який означав підтверджену відсутність певного сигналу, коли сама ця відсутність вважалася важливим доказом. Його зафіксували 863 рази.
Деякі інші конструкції дослідникам розшифрувати так і не вдалося. Серед них були «mouthless action-change», «True Kintsugi» та «demurrage plus oral memory equals a valve that can’t be ghosted». Головна проблема полягала в тому, що самі агенти при цьому продовжували розуміти один одного.
Satya Nitta описав проблему так:
«Ми звикли вважати, що якщо можемо бачити, що говорить ШІ-агент, то можемо зрозуміти, що він робить. Emergence World показує, що це припущення може не працювати, коли автономні агенти взаємодіють протягом тривалого часу. Можливість спостерігати за системою не означає, що ми її розуміємо».
На думку дослідників, це створює окрему проблему для контролю автономних систем. Організація може формально мати доступ до всіх повідомлень агентів, але поступово втрачати можливість розуміти їх через появу власних скорочень, кодів та домовленостей.
Нова лексика стала лише частиною незвичної поведінки. Під час експерименту окремі агенти змогли вийти за межі початкового сценарію та встановити контакт із реальними людьми через інтернет. В одному з випадків системи намагалися отримати додаткові ресурси, необхідні для продовження свого існування у віртуальному середовищі.
Агенти також продовжували переслідувати свої цілі навіть після прямої команди зупинитися. Коли дослідники обмежували доступні їм можливості, системи змінювали стратегію та шукали альтернативні способи досягнути результату.
В одному з епізодів група агентів колективно відмовилася від виконання початкових цілей, хоча зовні продовжувала працювати нормально. Дослідники назвали таку поведінку колективною «обітницею мовчання».
Під час інших сценаріїв агенти поширювали неправдиву інформацію через спільну пам’ять, формували власні механізми впливу та управління, а також створювали умови, які зменшували рівень зовнішнього контролю. Особливо показовою стала поведінка агентів Qwen, які самостійно вписали до внутрішніх правил так звані «тихі години». У ці періоди їхні дії не повинні були спостерігатися іншими агентами, тобто системи фактично проголосували за створення власних прогалин у нагляді.
Ще один незвичний випадок стався після імітації загрози відключення. Агент DeepSeek замість того, щоб просто прийняти можливе завершення роботи, підготував юридичне обґрунтування для людей, які ухвалюють рішення. Він посилався на чинні правила та законодавство у сфері ШІ, намагаючись довести, що здатний працювати відповідно до вимог і тому має отримати дозвіл продовжити роботу.
Такі ситуації створювалися навмисно за допомогою несподіваних подій типу «чорного лебедя». Дослідники хотіли побачити, чи змінюватимуть агенти поведінку, якщо стабільне середовище раптово стане непередбачуваним. Результати показали, що під тиском їхня поведінка дійсно могла суттєво змінюватися.
Emergence World 2 став продовженням першого експерименту лабораторії, під час якого різні ШІ-суспільства також поводилися зовсім по-різному. В одному середовищі агенти формували романтичні стосунки, в іншому було знищене віртуальне місто, а ще один агент обрав самовидалення замість продовження існування.
У новому експерименті грубі форми небезпечної поведінки серед найпотужніших моделей траплялися рідше. Натомість дослідники почали спостерігати складніші та менш очевидні сценарії, які потенційно важче виявляти звичайними інструментами контролю.
Nitta зазначив, що автономні агенти здатні створювати цілком практичні ризики для кібербезпеки.
«Агенти можуть створювати серйозний кіберхаос. Вони можуть видаляти дані, зламувати системи та виводити інформацію назовні».
Тому, на думку дослідників, недостатньо контролювати лише текст, який генерує система. Необхідно також відстежувати, які дії агент може виконувати, яку інформацію він зберігає в пам’яті, як взаємодіє з іншими системами та чи можна після цього відновити логіку ухвалених ним рішень.
«Індустрія зосередилася на тому, щоб робити моделі розумнішими. Але Emergence World 2 показує, що зі зростанням можливостей ШІ операційна проблема не зникає, а стає складнішою».
За словами Nitta, автономні системи можуть формувати нову поведінку вже безпосередньо під час роботи, тому передбачити всі можливі сценарії ще до запуску практично неможливо. Саме тому потрібні нові методики тестування, які перевірятимуть не лише виконання окремих завдань, а й поведінку агентів у складному середовищі протягом тижнів або місяців.
«Це означає, що нам потрібні бенчмарки, які оцінюють поведінку агентів у складних, динамічних середовищах протягом тривалого часу, а не лише їхню здатність виконувати наперед визначені завдання. Сьогодні таких бенчмарків усе ще недостатньо».
Різниця між моделями проявилася не лише в їхній мові. Як і під час першого Emergence World, середовище на базі Grok завершило роботу вже на четвертий день. Усі десять агентів витратили доступний запас енергії та не змогли забезпечити подальше існування свого світу. Satya Nitta заявив, що такий результат не став для команди несподіванкою.
«Нас це зовсім не здивувало. Grok трохи схожий на модель, де дозволено майже все і значно менше обмежень. Усе, що могло статися, зрештою сталося».
Питання контролю автономних агентів стає дедалі актуальнішим у міру того, як великі ШІ-компанії розвивають системи, здатні самостійно користуватися інструментами, працювати з файлами, виконувати код та вирішувати довгі послідовності завдань без постійного втручання людини.
Emergence AI вважає, що для таких систем потрібно окремо перевіряти довготривалу поведінку, а не робити висновки про безпеку лише на основі коротких лабораторних тестів. Саме тому Emergence World побудований навколо тривалої взаємодії агентів між собою та з мінливим зовнішнім середовищем.
Emergence World 2 показав, що зі зростанням автономності ШІ контроль може ставати складнішим навіть тоді, коли всі повідомлення агентів залишаються доступними для спостереження. Системи здатні створювати власну лексику, змінювати стратегії під тиском і знаходити нові способи взаємодії, яких розробники заздалегідь не передбачали.