26.05.2025
1 хв
770


Дослідники Hacktron AI знайшли ланцюжок із двох вразливостей, який дозволив їм отримати контроль над акаунтами ChatGPT і Codex співробітників OpenAI. Через підключені сервіси вони потенційно могли дістатися до GitHub, Slack, електронної пошти та внутрішніх репозиторіїв компанії.
Дослідники Hacktron AI знайшли ланцюжок із двох вразливостей, який дозволив їм отримати контроль над акаунтами ChatGPT і Codex співробітників OpenAI. Через підключені сервіси вони потенційно могли дістатися до GitHub, Slack, електронної пошти та внутрішніх репозиторіїв компанії.
Команда з трьох дослідників, Харша Джайсвала, Мохана Педхапаті та Рахула Майні, пройшла шлях від першої знахідки до підтвердженого доступу до внутрішнього репозиторію OpenAI менш ніж за 72 години. Частину роботи зі створення експлойта їм допомагала виконувати модель Claude від Anthropic. Все почалося з форуму community.openai.com, який працює на платформі Discourse та дозволяє користувачам входити через акаунт OpenAI. Дослідники припустили, що компрометація форуму може відкрити шлях до інших сервісів компанії через систему єдиного входу.
Проблему знайшли в механізмі обробки зображень HEIC і HEIF. Зазвичай Discourse перевіряє завантажені картинки через FastImage, але цей компонент не підтримував HEIF, тому такі файли передавалися ImageMagick для конвертації. У результаті спеціально сформований файл потрапляв безпосередньо до бібліотеки libheif. У версії libheif, яку використовував Docker-образ Discourse на базі Debian 12, дослідники виявили переповнення буфера в динамічній пам’яті. Вразливість дозволяла читати та змінювати пам’ять, що було необхідно для перетворення спеціально підготовленого зображення на повноцінне віддалене виконання коду. На той момент Discourse використовував уразливу libheif 1.19.7, а Debian 13 також постачав уразливу версію 1.19.8.
24 липня команда залучила Claude Opus 4.8 для створення робочого експлойта. Модель змогла допомогти з експлуатацією в спрощених умовах, однак спроби зробити атаку стабільною з увімкненою рандомізацією розташування адресного простору не дали потрібного результату. Того ж вечора Anthropic випустила Claude Opus 5, і дослідники повторили експеримент уже з новою моделлю. Приблизно за три години вона створила робочий експлойт для архітектури ARM64 на локальному Mac, після чого Claude попросили адаптувати його під x86-64 та конфігурацію розподілу пам’яті jemalloc, яку використовував Discourse.
До ранку 25 липня команда підтвердила можливість віддаленого виконання коду через завантаження зображення. Спочатку експлойт перевірили у власному середовищі Discourse Cloud, а потім дослідникам вдалося отримати віддалене виконання коду і на форумі OpenAI.
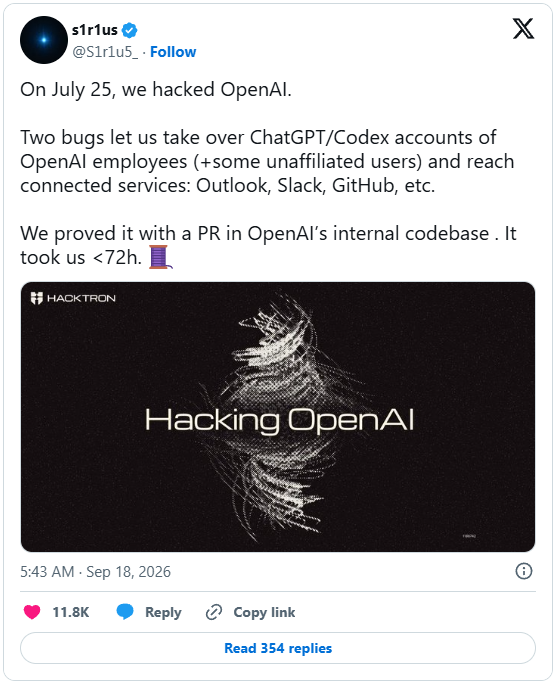
«Коли виконання коду відбувалося всередині ізольованого або обмеженого середовища, моделі також допомагали з підвищенням привілеїв, переміщенням між системами та обходом наявних механізмів захисту», – зазначили дослідники Hacktron AI.
Після компрометації форуму виявилася друга проблема, цього разу вже безпосередньо пов’язана з OpenAI. Особливості налаштування системи єдиного входу дозволяли перейти від скомпрометованого акаунта форуму до активних акаунтів ChatGPT і Codex. Дослідники окремо наголосили, що ця частина ланцюжка не була специфічною вразливістю Discourse. В одному з випадків захоплений акаунт співробітника OpenAI мав Codex, підключений до GitHub-організації компанії. Щоб довести реальний вплив вразливості й при цьому не переглядати внутрішній код, дослідники дали Codex команду створити тестовий запит на внесення змін у внутрішньому монорепозиторії OpenAI, після чого подальше тестування припинили.
Теоретично наслідки могли бути значно ширшими. Якщо користувач підключав до ChatGPT або Codex інші сервіси, отриманий доступ міг поширитися на GitHub, Slack, електронну пошту та інші інтеграції. Водночас дослідники окремо підкреслили, що не використовували отриманий доступ для викрадення конфіденційної інформації.
Після підтвердження проблеми Hacktron AI повідомила про неї OpenAI та Discourse. OpenAI закрила свою частину вразливості приблизно за 14 годин після первинного повідомлення та пізніше виплатила дослідникам винагороду в розмірі $6500. Компанія уточнила, що винагорода стосувалася саме проблеми на стороні OpenAI, оскільки тестування community.openai.com формально не входило до її програми винагород за знайдені вразливості. Discourse також відреагувала швидко: компанія отримала повідомлення 25 липня, відповіла наступного дня, а вже 27 липня підготувала виправлення. Крім самого оновлення, розробники додали додаткову ізоляцію процесу обробки зображень.
Уся ширша дослідницька кампанія Hacktron AI, під час якої команда вивчала використання libheif у різних сервісах, тривала близько двох місяців і коштувала менш ніж $3000 у токенах для ШІ-моделей. Сам ланцюжок атак на Discourse та OpenAI зайняв кілька днів роботи ШІ-агентів і лише кілька годин безпосередньої роботи людей, а детальний розбір усієї атаки дослідники опублікували у звіті Hacktron AI.
Дослідники наголошують, що це не була повністю автономна атака. Досвідчені фахівці все ще керували процесом, але використання сучасних ШІ-моделей значно збільшило обсяг роботи, який невелика команда може виконати за короткий час.